- Case study: công ty chứng khoán dựng hệ thống giao dịch HA (minh họa)
- Study hệ thống giao dịch ha: bối cảnh: vì sao hệ thống cũ sập?
- Study hệ thống giao dịch ha: yêu cầu kỹ thuật của hệ thống giao dịch chứng khoán
- Study hệ thống giao dịch ha: kiến trúc tổng thể hướng HA
- Database HA: trái tim của hệ thống
- Failover: khi sự cố xảy ra thì sao?
- Giám sát và cảnh báo theo thời gian thực
- Kế hoạch DR cho kịch bản thảm họa
- Bài toán chi phí: HA đắt đến đâu?
- 5 bài học rút ra
- Kết luận
- Bài viết liên quan
- Câu hỏi thường gặp
Case study: công ty chứng khoán dựng hệ thống giao dịch HA (minh họa)
9h15 sáng, 15 phút sau khi thị trường mở cửa, màn hình đặt lệnh của hàng nghìn nhà đầu tư đồng loạt báo lỗi kết nối. Hệ thống giao dịch của một công ty chứng khoán vừa "sập" đúng giờ cao điểm — mỗi phút downtime là hàng tỷ đồng giá trị giao dịch bị kẹt và niềm tin khách hàng sụt giảm. Kịch bản dưới đây là case study minh họa (tình huống giả định, số liệu minh họa) về cách một công ty chứng khoán thiết kế lại hệ thống giao dịch theo hướng HA (High Availability) để không bao giờ lặp lại sự cố đó.
Dù là tình huống minh họa, kiến trúc và các quyết định kỹ thuật trong bài đều dựa trên thực tế triển khai hệ thống tài chính: yêu cầu uptime, bài toán failover, và những đánh đổi không thể tránh.
Study hệ thống giao dịch ha: bối cảnh: vì sao hệ thống cũ sập?
Công ty chứng khoán trong case study (gọi là CTCK Alpha) có khoảng 50.000 tài khoản giao dịch trực tuyến. Hệ thống cũ chạy theo mô hình "single everything":
- Một máy chủ ứng dụng duy nhất xử lý đặt lệnh — không có bản dự phòng nóng.
- Một database chạy trên cùng cụm với ứng dụng, backup mỗi đêm ra ổ cứng gắn ngoài.
- Một đường truyền internet duy nhất từ nhà mạng, không có line dự phòng.
- Triển khai bản mới bằng cách dừng hệ thống 30 phút mỗi tối.
Sự cố xảy ra khi ổ cứng máy chủ ứng dụng lỗi đúng lúc lưu lượng đặt lệnh tăng vọt đầu phiên. Không có máy dự phòng, đội kỹ thuật mất 47 phút để dựng lại từ backup đêm qua — và mất toàn bộ lệnh trong 15 phút đầu phiên. Thiệt hại ước tính (minh họa): hàng tỷ đồng phí giao dịch + bồi thường khách hàng VIP.
Bài học đầu tiên: với hệ thống giao dịch, HA không phải tính năng cộng thêm mà là yêu cầu sống còn. Mục tiêu đặt ra cho hệ thống mới: uptime 99,95% (downtime tối đa ~22 phút/tháng), RPO ≈ 0 (không mất dữ liệu giao dịch), RTO < 5 phút.
Study hệ thống giao dịch ha: yêu cầu kỹ thuật của hệ thống giao dịch chứng khoán
Trước khi vẽ kiến trúc, đội ngũ xác định các yêu cầu ràng buộc đặc thù ngành:
Tính đúng đắn tuyệt đối. Lệnh mua/bán không được mất, không được trùng, không được sai thứ tự. Điều này loại bỏ các giải pháp "eventual consistency" lỏng lẻo cho lõi giao dịch — database phải đảm bảo ACID nghiêm ngặt.
Độ trễ thấp. Nhà đầu tư so sánh tốc độ khớp lệnh giữa các công ty. Mục tiêu: thời gian từ khi nhận lệnh đến khi phản hồi dưới 100ms trong điều kiện tải cao điểm. Điều này ảnh hưởng đến vị trí đặt máy chủ (gần Sở Giao dịch, dùng colocation trong nước thay vì cloud quốc tế latency cao).
Tuân thủ và kiểm toán. Mọi lệnh, mọi thay đổi trạng thái phải ghi log không thể sửa (immutable audit log), lưu tối thiểu 5–10 năm theo quy định. Hệ thống phải tách bạch môi trường dev/staging/production.
Burst tải theo phiên. Khác với website thương mại điện tử tải rải đều, hệ thống chứng khoán có 2 đỉnh tải sắc nhọn: 9h–9h30 (mở cửa) và 14h–14h30 (đóng cửa), gấp 8–10 lần tải trung bình. Kiến trúc phải chịu được burst mà không cần duy trì công suất đỉnh 24/7 (lãng phí).
Study hệ thống giao dịch ha: kiến trúc tổng thể hướng HA
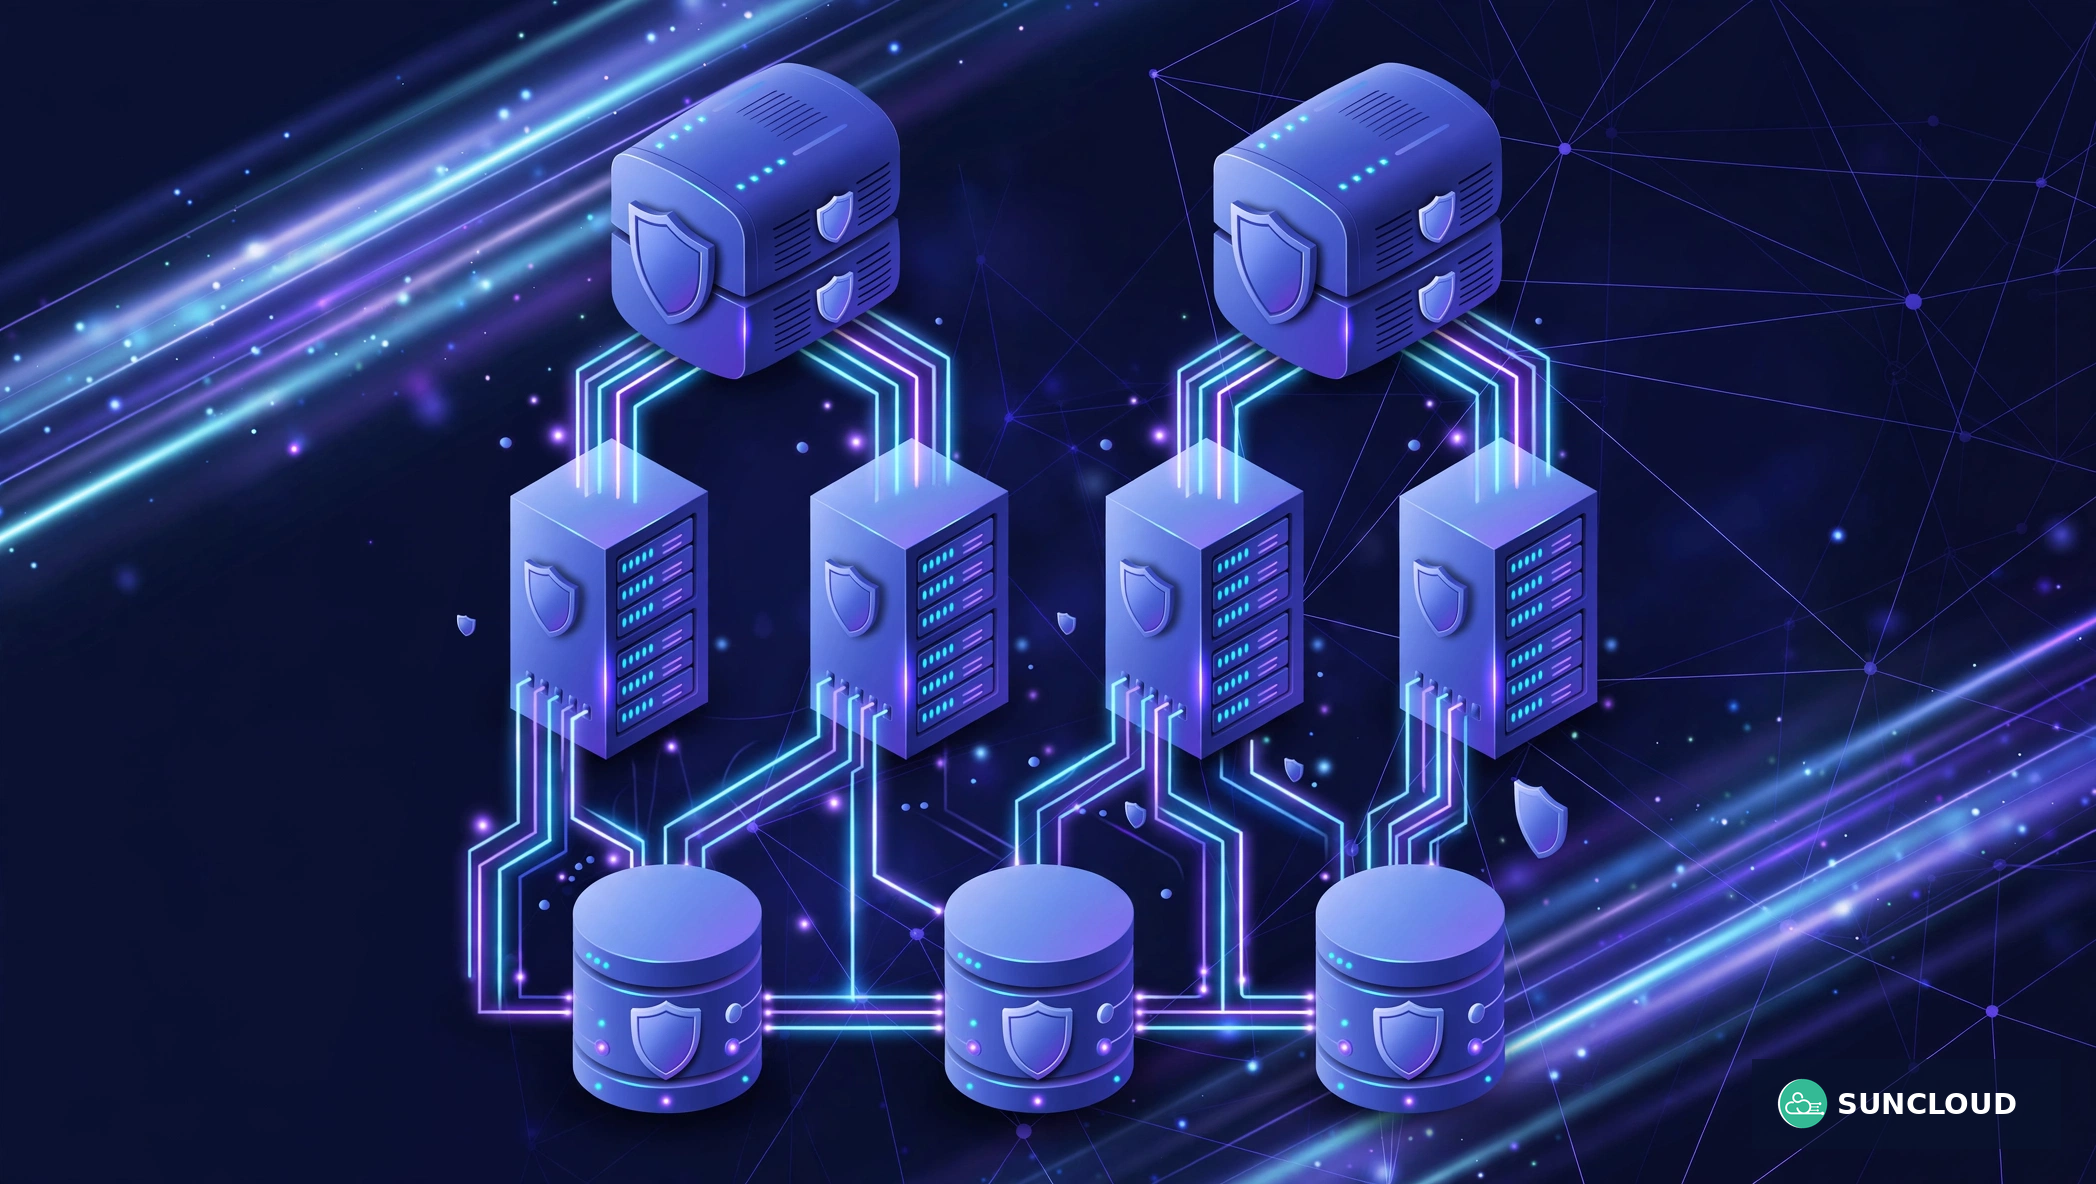
Hệ thống mới được thiết kế theo nguyên tắc "không có điểm chết đơn" (no single point of failure) ở mọi tầng:
Tầng edge: 2 đường truyền từ 2 nhà mạng khác nhau (active-active qua BGP), 2 firewall cluster HA, 2 load balancer chạy cặp active-standby với virtual IP tự động chuyển đổi khi một node lỗi.
Tầng ứng dụng: 3+ node ứng dụng đặt lệnh chạy song song sau load balancer (stateless — session lưu ở tầng cache tập trung, không lưu trên node). Một node chết, load balancer tự loại khỏi pool trong vài giây, người dùng không cảm nhận được.
Tầng dữ liệu: database chính + 1 standby đồng bộ (synchronous replication) trong cùng datacenter + 1 standby bất đồng bộ ở datacenter dự phòng khác tỉnh. Chi tiết ở mục database bên dưới.
Tầng hạ tầng: triển khai trên 2 availability zone (2 phòng máy độc lập điện + mạng) trong cùng datacenter Tier III, cộng 1 site DR ở tỉnh khác cho kịch bản thảm họa.
| Tầng | Trước đây (single) | Sau khi làm HA |
|---|---|---|
| Đường truyền | 1 line | 2 line, 2 nhà mạng, BGP |
| Firewall/LB | 1 chiếc | Cluster HA active-standby |
| App server | 1 máy | 3+ node stateless + LB |
| Database | 1 DB, backup đêm | Sync standby + async DR site |
| Triển khai | Dừng hệ thống 30 phút | Rolling update, zero-downtime |
| RTO/RPO | 47 phút / mất 15 phút dữ liệu | < 5 phút / ≈ 0 |
Database HA: trái tim của hệ thống
Với hệ thống giao dịch, database là thành phần khó làm HA nhất — vì không được phép mất hay sai một giao dịch nào. Thiết kế được chọn:
Synchronous replication trong datacenter chính. Mỗi giao dịch chỉ được coi là "thành công" khi đã ghi xuống cả node chính và node standby đồng bộ. Đảm bảo RPO = 0 khi node chính chết: standby lên thay trong 1–2 phút với đầy đủ dữ liệu. Cái giá: độ trễ ghi tăng thêm vài mili giây (chấp nhận được trong cùng datacenter).
Asynchronous standby ở site DR. Node thứ ba ở tỉnh khác nhận replication bất đồng bộ, độ trễ dữ liệu vài giây. Dùng cho kịch bản datacenter chính mất hoàn toàn (cháy, lũ). RPO trong kịch bản này là vài giây — chấp nhận được cho thảm họa cấp vùng.
Tách đọc/ghi (read-write splitting). Các truy vấn tra cứu (bảng giá, lịch sử lệnh) được chuyển sang read replica, giảm tải cho node chính trong giờ cao điểm. Ước tính (minh họa): 70% lưu lượng database là đọc — tách ra giúp node chính "thở" được đúng lúc cần nhất.
Backup đa lớp: full backup hàng đêm + WAL/archive log liên tục 15 phút/lần, lưu 3 bản (local, site DR, object storage). Kịch bản xấu nhất vẫn dựng lại được tới thời điểm 15 phút trước sự cố.
Failover: khi sự cố xảy ra thì sao?
Kiến trúc HA chỉ có giá trị khi failover (chuyển đổi dự phòng) diễn ra đúng. Quy trình được tự động hóa tối đa:
Phát hiện (detection): hệ thống giám sát kiểm tra heartbeat mỗi 5 giây. Mất 3 heartbeat liên tiếp (15 giây) → tuyên bố node lỗi. Ngưỡng này cân bằng giữa phát hiện nhanh và tránh "báo động giả" khi mạng giật cục.
Chuyển đổi (failover): với tầng ứng dụng, load balancer tự loại node chết — không cần can thiệp người. Với database, cluster manager (ví dụ Patroni) bầu node standby thành primary mới trong 60–120 giây. Với đường truyền, BGP tự chuyển traffic sang line còn lại.
Kiểm chứng (verification): sau failover, hệ thống tự chạy bộ kiểm tra: đếm số lệnh trong 5 phút trước/sau, đối chiếu số dư tài khoản mẫu, xác nhận không có lệnh trùng. Chỉ khi pass hết mới tuyên bố "đã ổn định".
Diễn tập định kỳ: mỗi quý một lần, đội ngũ chủ động giết một node production trong giờ thấp điểm (chaos engineering có kiểm soát) để chắc chắn failover vẫn hoạt động. Quy tắc: cái gì không diễn tập thì coi như không có.
Giám sát và cảnh báo theo thời gian thực
Hệ thống HA mà "mù" thì vẫn nguy hiểm. Stack giám sát được dựng gồm:
- Metrics: thu thập mỗi 10 giây — CPU, RAM, disk IOPS, connection database, độ trễ API đặt lệnh (p95, p99), hàng đợi message.
- Log tập trung: mọi service đẩy log về trung tâm, giữ 90 ngày hot + archive 5 năm cho kiểm toán.
- Tracing: theo dõi một lệnh đi qua bao nhiêu service, phát hiện điểm nghẽn khi độ trễ tăng.
- Cảnh báo phân tầng: warning (Telegram/email) khi tài nguyên > 70%, critical (gọi điện/SMS) khi service lỗi hoặc độ trễ vượt ngưỡng. Quy tắc: cảnh báo phải hành động được — alert nào không ai biết phải làm gì thì xóa đi.
Dashboard "một màn hình" cho ca trực hiển thị: trạng thái từng tầng (xanh/vàng/đỏ), số lệnh/phút realtime, độ trễ p99, và nút "kích hoạt DR" cho tình huống khẩn cấp.
Kế hoạch DR cho kịch bản thảm họa
HA trong một datacenter không chống được cháy nổ, lũ lụt. Site DR ở tỉnh khác được duy trì ở chế độ warm standby: hạ tầng dựng sẵn, database async standby luôn đồng bộ (trễ vài giây), ứng dụng ở trạng thái tắt nhưng cấu hình sẵn sàng bật trong 15–30 phút.
Thứ tự ưu tiên khôi phục khi mất datacenter chính: (1) database DR lên primary, (2) bật ứng dụng ở site DR, (3) chuyển DNS/BGP sang site DR, (4) thông báo khách hàng. RTO mục tiêu: 30 phút cho thảm họa cấp vùng. Mỗi 6 tháng diễn tập chuyển đổi DR một lần — lần diễn tập đầu tiên (minh họa) phát hiện ra DNS TTL đặt 24 giờ khiến chuyển đổi thực tế mất cả ngày; sau đó giảm xuống 60 giây.
Bài toán chi phí: HA đắt đến đâu?
Minh họa cơ cấu chi phí hệ thống mới so với cũ (số liệu minh họa, chưa VAT):
| Hạng mục | Hệ thống cũ | Hệ thống HA mới |
|---|---|---|
| Máy chủ (thuê/vận hành) | 1 cụm ~40 triệu/tháng | 3 cụm + DR ~120 triệu/tháng |
| Đường truyền | 1 line ~10 triệu/tháng | 2 line 2 nhà mạng ~22 triệu/tháng |
| License/giám sát | ~5 triệu/tháng | ~15 triệu/tháng |
| Nhân sự vận hành | 2 người | 4 người (trực 24/7) |
| Tổng | ~55 triệu/tháng | ~157 triệu/tháng |
Đắt gấp ~3 lần — nhưng so với thiệt hại một lần sập hệ thống giờ cao điểm (ước tính hàng tỷ đồng + mất khách hàng), đây là khoản bảo hiểm rẻ. Với công ty chứng khoán, uptime chính là sản phẩm.
Cách tối ưu: dùng colocation + máy chủ thuê trong nước thay vì mua sắm (giảm CAPEX), triển khai theo giai đoạn (HA tầng ứng dụng trước, DR site sau 6 tháng), và tận dụng giờ thấp điểm để chạy batch trên cùng hạ tầng.
5 bài học rút ra
1. HA là thiết kế, không phải mua thêm máy. Chồng thêm server vào kiến trúc single-point-of-failure không tạo ra HA. Phải thiết kế stateless, health check, và failover tự động từ đầu.
2. Database quyết định RPO. Mọi tầng khác failover trong giây được, riêng database cần synchronous replication mới đảm bảo không mất giao dịch. Đừng tiết kiệm ở tầng dữ liệu.
3. Diễn tập quan trọng hơn tài liệu. Quy trình failover viết 50 trang mà chưa từng chạy thử thì khi sự cố thật, người ta vẫn lúng túng. Chaos engineering định kỳ là bắt buộc.
4. Giám sát phải đi trước HA. Không đo được thì không biết khi nào cần failover. Đầu tư giám sát trước khi đầu tư phần cứng dự phòng.
5. Con người là mắt xích cuối. Quy trình on-call rõ ràng, runbook cho từng kịch bản, và văn hóa "báo động giả cũng phải xem" quyết định RTO thực tế.
Kết luận
Case study minh họa trên cho thấy dựng hệ thống giao dịch HA cho công ty chứng khoán là bài toán tổng thể: kiến trúc không điểm chết đơn ở mọi tầng, database synchronous replication đảm bảo RPO ≈ 0, failover tự động kèm diễn tập định kỳ, giám sát realtime và site DR cho thảm họa cấp vùng. Chi phí cao gấp 2–3 lần hệ thống thường, nhưng đó là cái giá của niềm tin trong ngành tài chính.
Nếu doanh nghiệp bạn đang vận hành hệ thống không thể sập — tài chính, y tế, thương mại điện tử giờ cao điểm — hãy bắt đầu từ đánh giá điểm chết đơn hiện tại. SunCloud cung cấp hạ tầng colocation Tier III, Cloud Server HA và dịch vụ tư vấn kiến trúc với đội ngũ am hiểu workload tài chính. Liên hệ hotline 083 979 3434 hoặc email sales@suncloud.vn hoặc truy cập suncloud.vn để được tư vấn.
Bài viết liên quan
- Dịch vụ Cloud Server SunCloud
- Case study: công ty logistics giảm 40% chi phí hạ tầng nhờ colocation
- Case study: công ty game mobile chịu tải 50.000 CCU ngày ra mắt
Câu hỏi thường gặp
HA 99,95% nghĩa là gì trong thực tế?
Nghĩa là hệ thống được phép downtime tối đa khoảng 22 phút mỗi tháng (hoặc 4,4 giờ/năm). Với hệ thống giao dịch chứng khoán, 22 phút này phải rơi vào ngoài giờ giao dịch — vì vậy mục tiêu vận hành thực tế thường cao hơn con số cam kết.
RPO và RTO khác nhau thế nào?
RPO (Recovery Point Objective) là lượng dữ liệu tối đa chấp nhận mất, tính bằng thời gian (ví dụ RPO 15 phút = mất tối đa 15 phút dữ liệu). RTO (Recovery Time Objective) là thời gian tối đa để khôi phục hệ thống hoạt động. Với giao dịch chứng khoán, RPO ≈ 0 là bắt buộc, RTO < 5 phút là mục tiêu.
Có cần 2 datacenter ngay từ đầu không?
Không nhất thiết. Lộ trình hợp lý: giai đoạn 1 làm HA trong một datacenter Tier III (chống được 95% sự cố thường gặp: hỏng phần cứng, lỗi phần mềm, mất điện cục bộ); giai đoạn 2 (6–12 tháng sau) bổ sung site DR cho thảm họa cấp vùng.
Synchronous replication có làm chậm hệ thống không?
Có, thêm vài mili giây cho mỗi ghi vì phải chờ standby xác nhận. Trong cùng datacenter (độ trễ mạng < 1ms), ảnh hưởng không đáng kể với giao dịch chứng khoán. Chỉ khi replicate qua khoảng cách địa lý lớn mới thành vấn đề — đó là lý do standby đồng bộ đặt cùng site, standby bất đồng bộ đặt xa.
Chi phí HA có cách nào giảm không?
Có: thuê máy chủ/colocation thay vì mua (giảm CAPEX); dùng open-source cho cluster manager và giám sát; triển khai theo giai đoạn; và quan trọng nhất — chỉ làm HA cho lõi giao dịch, các hệ thống phụ (website giới thiệu, CRM) có thể ở mức HA thấp hơn.