- Migrate database zero-downtime: chuyển DB mà app không ngừng 1 giây
- Migrate database zero downtime: vì sao migrate database truyền thống phải downtime?
- Migrate database zero downtime: 4 phương pháp migrate zero-downtime phổ biến
- Migrate database zero downtime: quy trình migrate bằng replication: 8 bước chi tiết
- Xử lý 5 thách thức khó nhất khi migrate
- Checklist an toàn trước giờ G
- So sánh công cụ migrate: AWS DMS, Debezium, Percona
- Khi nào KHÔNG nên cố zero-downtime?
- Ước tính thời gian migrate theo dung lượng database
- Migrate lên cloud: tận dụng dịch vụ của nhà cung cấp
- Kết luận
- Câu hỏi thường gặp
- Migrate zero-downtime có thực sự "zero" tuyệt đối không?
- Database bao lớn thì nên dùng replication thay vì dump/restore?
- Có migrate được từ MySQL sang PostgreSQL zero-downtime không?
- Replication lag bao nhiêu thì an toàn để cutover?
- Quên migrate stored procedure thì sao?
- Có nên tự migrate hay thuê dịch vụ?
Migrate database zero-downtime: chuyển DB mà app không ngừng 1 giây
"Chuyển database sang server mới nhé, downtime khoảng 4 tiếng đêm nay." — Câu nói này từng là bình thường, nhưng năm 2027 thì không còn chấp nhận được nữa. Sàn TMĐT chạy 24/7, app ngân hàng, hệ thống đặt vé — mỗi phút ngừng hoạt động là doanh thu mất trắng và khách hàng bỏ đi. Tin tốt là migrate database zero downtime hoàn toàn khả thi: chuyển toàn bộ database sang hạ tầng mới mà ứng dụng không ngừng một giây nào.
Bài viết này trình bày các phương pháp migrate database không downtime đã được kiểm chứng: replication, dual-write, từng bước chi tiết, checklist an toàn, và những sai lầm khiến "zero-downtime" biến thành "downtime cả đêm".
Migrate database zero downtime: vì sao migrate database truyền thống phải downtime?
Để hiểu vì sao zero-downtime khó, cần hiểu vì sao cách cũ cần downtime. Migrate truyền thống gồm 3 bước:
- Tắt ứng dụng (downtime bắt đầu) — để không còn ghi mới nào vào database cũ.
- Dump + restore: xuất toàn bộ dữ liệu (có thể hàng trăm GB, mất hàng giờ) rồi nhập vào database mới.
- Bật ứng dụng trỏ sang database mới (downtime kết thúc).
Vấn đề: trong suốt quá trình dump/restore, hệ thống phải "đóng băng". Với database 500GB, chỉ riêng bước chuyển dữ liệu đã mất 3–6 giờ — chưa kể rủi ro restore lỗi phải làm lại từ đầu.
Migrate database zero downtime đảo ngược logic: thay vì "dừng rồi chuyển", ta "chuyển trong khi vẫn chạy" — đồng bộ dữ liệu liên tục sang database mới, rồi chuyển traffic qua một cách mượt mà. Downtime thực tế bằng 0, hoặc chỉ vài giây ở thời điểm cutover.
Migrate database zero downtime: 4 phương pháp migrate zero-downtime phổ biến
| Phương pháp | Cách hoạt động | Độ phức tạp | Phù hợp |
|---|---|---|---|
| Replication (master-slave) | DB mới làm slave, đồng bộ realtime từ DB cũ; khi kịp dữ liệu thì promote lên master | Trung bình | MySQL, PostgreSQL — phổ biến nhất |
| Dual-write | App ghi đồng thời vào cả DB cũ và mới; sau đó chỉ đọc DB mới | Cao | Khi đổi loại DB (SQL → NoSQL) |
| Dump + incremental sync | Dump toàn bộ một lần, rồi đồng bộ phần thay đổi (CDC) liên tục | Trung bình–cao | DB lớn, cần công cụ CDC (Debezium) |
| Dịch vụ migrate của cloud | AWS DMS, GCP Database Migration Service lo toàn bộ pipeline | Thấp | Lên cloud, ít nhân sự DBA |
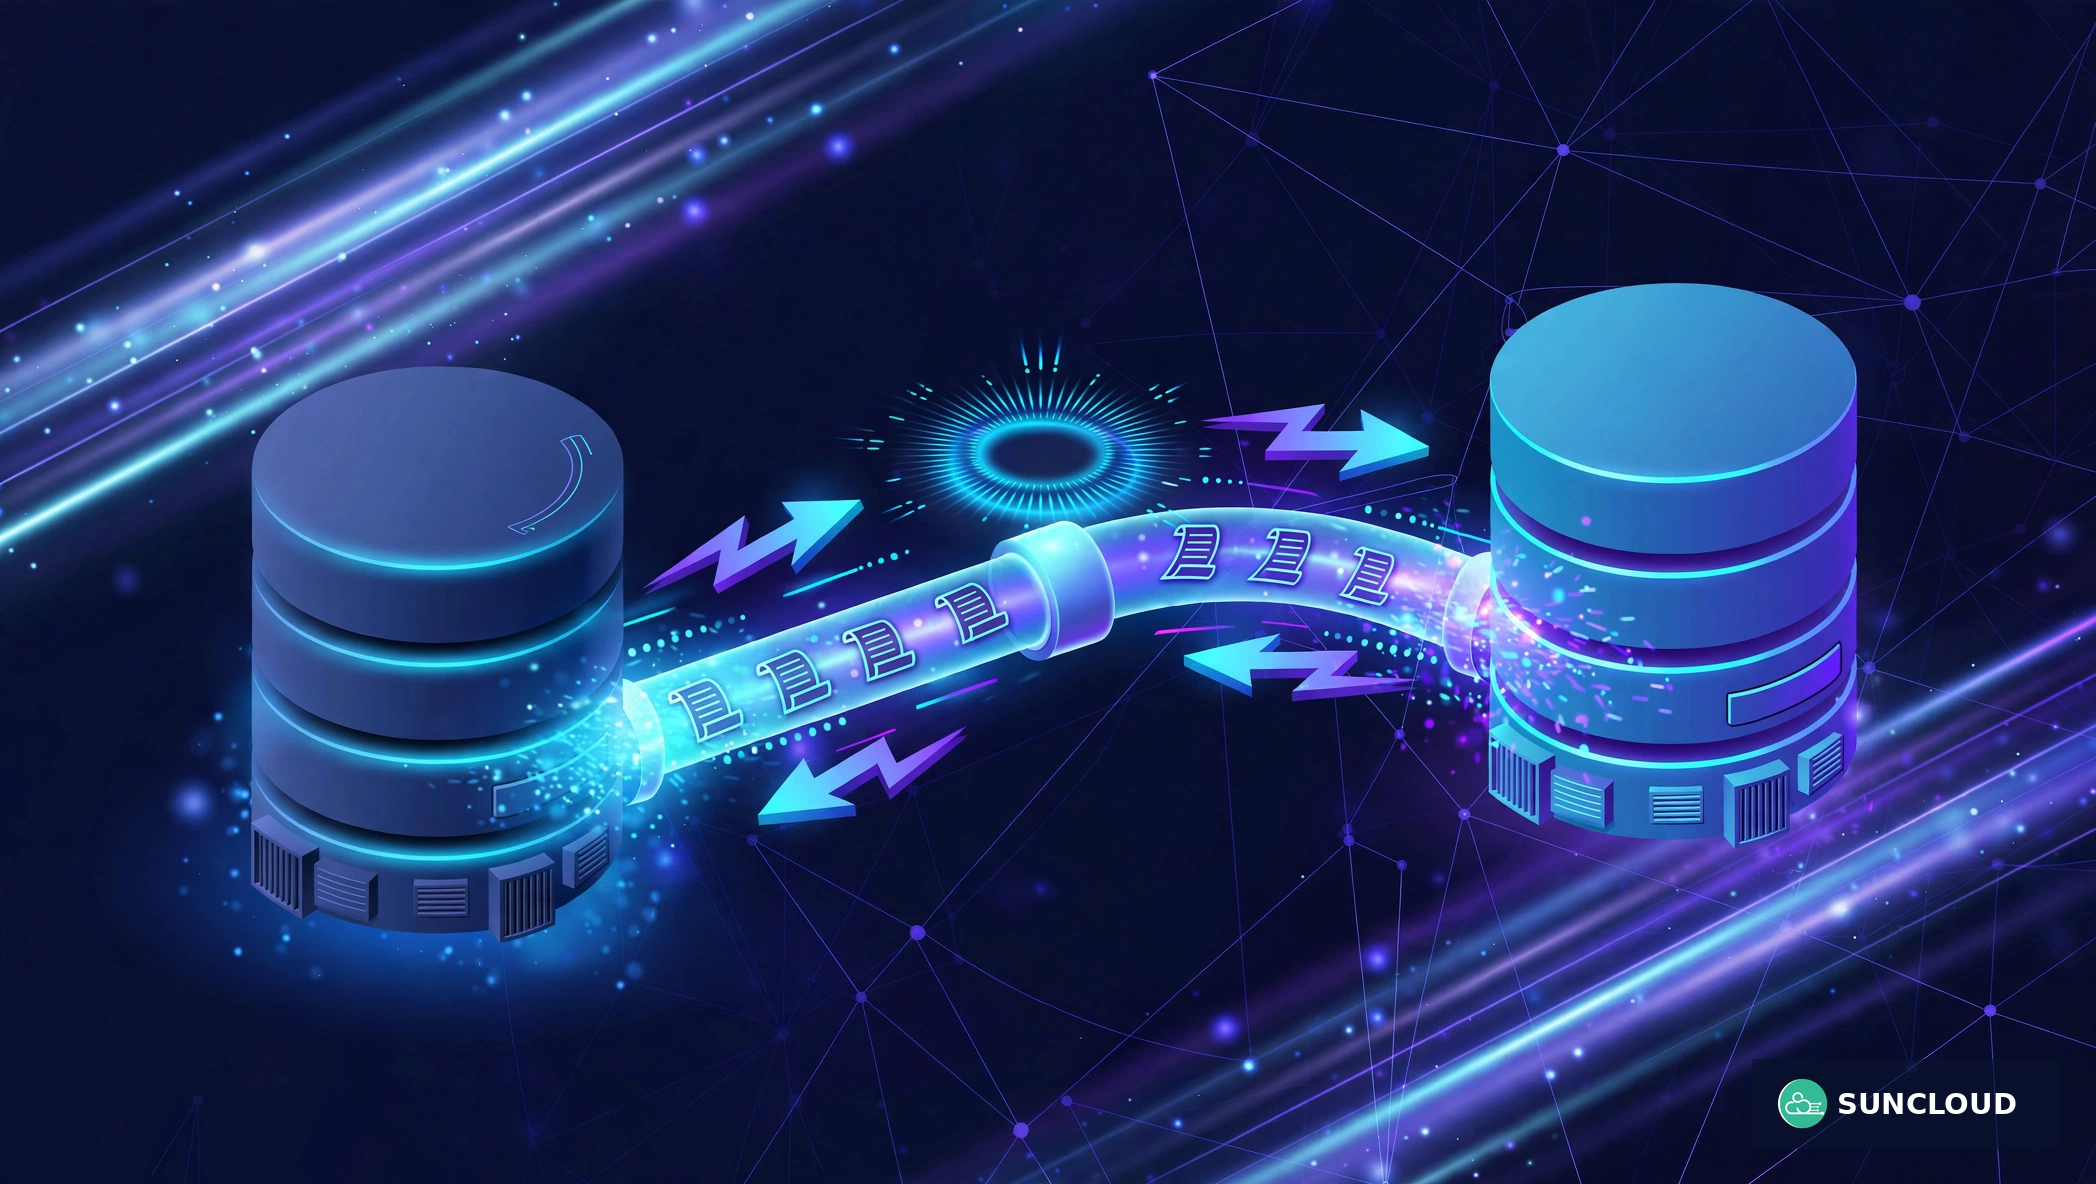
Replication là phương pháp "quốc dân" cho migrate cùng loại database (MySQL → MySQL, PostgreSQL → PostgreSQL): dựng DB mới làm bản sao, để nó "đuổi kịp" dữ liệu realtime qua binary log/WAL, kiểm tra đồng nhất, rồi chuyển app sang. Đơn giản, ít rủi ro nhất, và được cộng đồng kiểm chứng hàng chục năm.
Migrate database zero downtime: quy trình migrate bằng replication: 8 bước chi tiết
Bước 1: Chuẩn bị DB đích Cài đặt phiên bản database giống hệt DB nguồn (cùng minor version để tránh lỗi tương thích). Cấu hình server mới mạnh hơn hoặc tương đương — đừng migrate sang máy yếu hơn.
Bước 2: Snapshot ban đầu Chụp snapshot/physical backup DB nguồn (dùng Percona XtraBackup cho MySQL hoặc pg_basebackup cho PostgreSQL — cho phép backup nóng không khóa bảng).
Bước 3: Restore lên DB đích và thiết lập replication Restore snapshot lên DB mới, cấu hình nó làm slave trỏ về master cũ. Từ đây, mọi thay đổi trên DB cũ tự động chảy sang DB mới gần như realtime.
Bước 4: Theo dõi độ trễ replication (replication lag) Đây là chỉ số sống còn: lag phải về dưới 1 giây và ổn định. Nếu lag dao động lớn, kiểm tra: mạng giữa 2 DB, IOPS đĩa DB đích, hoặc long-running transaction trên nguồn.
Bước 5: Kiểm tra đồng nhất dữ liệu Chạy checksum so sánh (pt-table-checksum cho MySQL) trên các bảng quan trọng. Không bao giờ cutover khi dữ liệu chưa khớp 100%.
Bước 6: Diễn tập cutover trên môi trường staging Mô phỏng toàn bộ bước 7–8 với bản sao — đo thời gian, ghi lại mọi lệnh. Lần cutover thật phải như "diễn lại vở kịch đã tập".
Bước 7: Cutover — chuyển traffic Chọn thời điểm tải thấp nhất (thường 2–4 giờ sáng). Trình tự trong vài chục giây: chuyển DB cũ sang read-only → đợi slave "nuốt" hết log cuối → promote DB mới thành master → đổi connection string của app (qua DNS/proxy như ProxySQL để không cần deploy lại code) → mở ghi trở lại.
Bước 8: Giám sát sau cutover (24–72 giờ) Giữ DB cũ ở chế độ read-only thêm 3–7 ngày làm "phao cứu sinh" — nếu phát hiện vấn đề nghiêm trọng, có thể rollback. Chỉ xóa DB cũ khi mọi thứ ổn định và đã có backup mới đầy đủ.
Xử lý 5 thách thức khó nhất khi migrate
1. Replication lag không về 0 Nguyên nhân: single-threaded replication (MySQL cũ), đĩa DB đích chậm, hoặc transaction khổng lồ. Xử lý: bật parallel replication, nâng IOPS đĩa đích, chia nhỏ batch job lớn.
2. Schema khác nhau giữa 2 DB Nếu cần đổi schema trong lúc migrate (ví dụ tách bảng), dùng công cụ online schema change (gh-ost, pt-online-schema-change) — đừng ALTER TABLE trực tiếp trên bảng lớn vì nó khóa bảng.
3. Múi giờ và charset
Kiểm tra time_zone và charset (utf8mb4) giống hệt nhau. Lệch charset là nguyên nhân hàng đầu gây lỗi font tiếng Việt sau migrate — kiểm tra ngay với dữ liệu có dấu.
4. Stored procedure, trigger, event Các đối tượng này không tự "chạy theo" replication trong một số cấu hình — phải migrate thủ công và test kỹ. Quên trigger thanh toán là thảm họa.
5. Connection string cứng trong code App trỏ thẳng IP DB cũ thì cutover thành ác mộng. Chuẩn bị trước: chuyển qua domain/proxy (ProxySQL, PgBouncer) để đổi đích chỉ bằng một cấu hình.
Checklist an toàn trước giờ G
- [ ] Backup đầy đủ DB nguồn và test restore thành công (không test = không có backup)
- [ ] Replication lag < 1 giây ổn định ít nhất 24 giờ
- [ ] Checksum dữ liệu khớp 100% trên các bảng quan trọng
- [ ] Diễn tập cutover đầy đủ trên staging, ghi lại thời gian từng bước
- [ ] Kịch bản rollback đã viết sẵn: lệnh promote ngược, đổi connection string về
- [ ] Đội ngũ trực đủ: DBA, dev, infra — có kênh liên lạc khẩn cấp riêng
- [ ] Thông báo người dùng về "bảo trì" (dù kỳ vọng zero-downtime, luôn có kế hoạch B)
- [ ] Giám sát bật tối đa: slow query, error rate, replication status trong 72 giờ sau
Quy tắc bất di bất dịch: chưa diễn tập thành công trên staging thì chưa cutover production. Mọi vụ migrate thất bại mà tôi từng chứng kiến đều bỏ qua bước này.
So sánh công cụ migrate: AWS DMS, Debezium, Percona
| Công cụ | Loại | Giá | Điểm mạnh | Điểm yếu |
|---|---|---|---|---|
| AWS DMS | Dịch vụ cloud | Trả theo giờ dùng | Dễ nhất, có dashboard, hỗ trợ nhiều loại DB | Tốn phí, phụ thuộc AWS |
| Debezium + Kafka | Mã nguồn mở (CDC) | Miễn phí (tự vận hành) | Linh hoạt, realtime, cộng đồng lớn | Cần team giỏi Kafka |
| Percona XtraBackup | Công cụ backup nóng | Miễn phí | Backup MySQL không khóa bảng, tin cậy cao | Chỉ là bước snapshot, cần tự dựng replication |
| pg_basebackup + WAL | Công cụ PostgreSQL gốc | Miễn phí | Chuẩn gốc, ổn định nhất cho PG | Cần hiểu sâu về WAL/streaming |
| GCP Database Migration | Dịch vụ cloud | Trả theo giờ dùng | Tích hợp sâu GCP, ít cấu hình | Khóa hệ sinh thái Google |
Người mới bắt đầu: dùng dịch vụ migrate của cloud (AWS DMS hoặc GCP) — trả ít tiền để mua sự đơn giản và dashboard theo dõi. Team kỹ thuật vững: Debezium + Kafka cho pipeline CDC linh hoạt, hoặc Percona/pg_basebackup cho replication thủ công kiểm soát tuyệt đối.
Dù chọn công cụ nào, nguyên tắc không đổi: snapshot nhất quán → replication liên tục → lag dưới 1 giây → checksum khớp 100% → diễn tập → cutover → giữ DB cũ 3–7 ngày. Công cụ thay đổi, kỷ luật thì không.
Khi nào KHÔNG nên cố zero-downtime?
Zero-downtime không phải lúc nào cũng đáng giá. Hãy chấp nhận downtime có kế hoạch (vài chục phút nửa đêm) khi:
- Database nhỏ (< 10GB): dump/restore mất 15–30 phút — chi phí làm replication phức tạp không xứng đáng.
- Đổi loại database (MySQL → PostgreSQL): dual-write rất phức tạp, downtime ngắn + kiểm tra kỹ thường an toàn hơn.
- Hệ thống cho phép bảo trì: app nội bộ chỉ dùng giờ hành chính — đặt lịch 2 giờ sáng là xong.
- Team chưa từng làm replication: lần đầu làm production với kỹ thuật mới là rủi ro lớn nhất — hãy thuê chuyên gia hoặc chọn phương án đơn giản hơn.
Sự chuyên nghiệp không nằm ở "zero-downtime bằng mọi giá", mà ở chọn đúng phương pháp cho đúng hoàn cảnh và thực hiện nó một cách chắc chắn.
Ước tính thời gian migrate theo dung lượng database
Để lập kế hoạch thực tế, dưới đây là thời gian tham khảo cho từng giai đoạn (với đường truyền 1Gbps nội bộ và đĩa SSD):
| Dung lượng DB | Snapshot + restore ban đầu | Replication "đuổi kịp" | Kiểm tra + diễn tập | Tổng thời gian chuẩn bị |
|---|---|---|---|---|
| Dưới 50GB | 0,5–1 giờ | 1–2 giờ | 4–8 giờ | 1 ngày |
| 50–200GB | 2–4 giờ | 4–8 giờ | 1–2 ngày | 2–3 ngày |
| 200GB–1TB | 6–12 giờ | 12–24 giờ | 2–3 ngày | 4–5 ngày |
| Trên 1TB | 1–2 ngày | 1–3 ngày | 3–5 ngày | 1–2 tuần |
Lưu ý: thời gian cutover thực tế (lúc chuyển traffic) chỉ 1–5 phút trong mọi trường hợp — vì dữ liệu đã đồng bộ sẵn, cutover chỉ là thao tác chuyển đổi vai trò master. Toàn bộ thời gian trong bảng là công tác chuẩn bị, hệ thống vẫn chạy bình thường trong suốt quá trình đó. Đây chính là ý nghĩa của zero-downtime: người dùng không hề biết bạn đang migrate.
Mẹo tăng tốc: nén snapshot trước khi truyền (giảm 50–70% dung lượng với dữ liệu text-heavy), dùng mạng nội bộ riêng cho replication (tránh đi qua internet), và chạy restore với parallel jobs (pg_restore -j 8).
Migrate lên cloud: tận dụng dịch vụ của nhà cung cấp
Nếu điểm đến là cloud, đừng tự dựng replication thủ công — các dịch vụ migrate chuyên dụng làm tốt hơn:
- AWS DMS / GCP Database Migration Service: lo toàn bộ pipeline full-load + CDC, có dashboard theo dõi lag.
- Cloud Việt Nam: hỏi nhà cung cấp về dịch vụ hỗ trợ migrate — nhiều đơn vị (trong đó có SunCloud) hỗ trợ kỹ thuật migrate database khi khách hàng chuyển lên Cloud Server, từ tư vấn phương án đến đồng hành giờ cutover.
Dù dùng dịch vụ nào, checklist an toàn ở trên vẫn áp dụng đầy đủ — công cụ chỉ thay thế sức lao động, không thay thế kỷ luật quy trình.
Kết luận
Migrate database zero downtime không phải phép màu — đó là kỷ luật quy trình: replication đồng bộ realtime, kiểm tra đồng nhất 100%, diễn tập cutover trên staging, và luôn có kịch bản rollback. Với 8 bước trong bài viết, một team kỹ thuật vững hoàn toàn có thể chuyển database hàng trăm GB mà người dùng không hề hay biết.
Nếu bạn đang chuẩn bị migrate database lên hạ tầng mới và cần đội ngũ đồng hành — từ tư vấn phương án, chuẩn bị replication đến trực cùng giờ cutover — SunCloud sẵn sàng hỗ trợ. Liên hệ hotline 083 979 3434 hoặc truy cập suncloud.vn để trao đổi về kế hoạch migrate của bạn.
Câu hỏi thường gặp
Migrate zero-downtime có thực sự "zero" tuyệt đối không?
Gần như tuyệt đối với người dùng. Ở thời điểm cutover có thể có vài giây "read-only" khi chuyển master — người dùng chỉ cảm nhận như một lần load hơi chậm, không phải downtime.
Database bao lớn thì nên dùng replication thay vì dump/restore?
Ngưỡng thực tế khoảng 50–100GB. Dưới ngưỡng này, dump/restore trong cửa sổ bảo trì đêm thường đơn giản và an toàn hơn. Trên ngưỡng này, thời gian chuyển dữ liệu quá dài nên replication là lựa chọn hợp lý.
Có migrate được từ MySQL sang PostgreSQL zero-downtime không?
Được nhưng phức tạp — cần dual-write hoặc công cụ CDC như Debezium kèm chuyển đổi schema. Với khác biệt loại DB lớn, nhiều team chọn downtime ngắn có kế hoạch thay vì cố zero-downtime.
Replication lag bao nhiêu thì an toàn để cutover?
Dưới 1 giây và ổn định ít nhất 24 giờ. Nếu lag dao động (lúc 0.5s lúc 30s), đừng cutover — hãy tìm và xử lý nguyên nhân gốc trước.
Quên migrate stored procedure thì sao?
Đây là lỗi phổ biến và nguy hiểm. Luôn liệt kê đầy đủ stored procedure, trigger, event, view trước khi migrate và kiểm tra từng cái sau cutover. Dùng mysqldump --routines --events để không sót.
Có nên tự migrate hay thuê dịch vụ?
Nếu team đã quen với replication và có DBA kinh nghiệm, tự làm hoàn toàn được. Nếu lần đầu hoặc database là hệ thống sống còn (tài chính, y tế), thuê chuyên gia đồng hành giờ cutover là khoản bảo hiểm rẻ nhất.