- Replication MySQL master-slave: vừa HA vừa là lớp backup sống
- Replication mysql master slave: replication MySQL là gì?
- Replication mysql master slave: các mô hình replication phổ biến
- Replication mysql master slave: chuẩn bị trước khi dựng replication
- Các bước dựng master-slave cơ bản
- Failover: khi master sập thì làm gì?
- Giám sát replication: 3 chỉ số phải theo dõi mỗi ngày
- Replication làm "backup sống" như thế nào?
- 6 lỗi thường gặp và cách xử lý
- Khi nào nên nâng cấp lên Group Replication hoặc InnoDB Cluster?
- Kết luận
- Bài viết liên quan
- Câu hỏi thường gặp
- Có một số điểm cần lưu ý: MySQL 8.0 đổi cách xác thực mặc định (caching_sha2_password) có thể gây lỗi kết nối replication nếu client cũ; một số biến cấu hình đổi tên. Lộ trình an toàn: nâng slave trước, kiểm tra replication chạy ổn, rồi mới nâng master (failover sang slave đã nâng cấp).
Replication MySQL master-slave: vừa HA vừa là lớp backup sống
Database MySQL là "trái tim" của hầu hết website và ứng dụng SME — mà trái tim thì không được phép ngừng đập. Một server database duy nhất đồng nghĩa với hai rủi ro cùng lúc: sập là mất dịch vụ, và backup đêm qua thì luôn "cũ" vài tiếng. Replication MySQL master-slave giải quyết cả hai bằng một cơ chế: nhân bản dữ liệu liên tục sang máy chủ dự phòng — vừa sẵn sàng thay thế khi máy chính sập (HA), vừa là một lớp backup sống luôn mới đến từng giây. Bài viết này giải thích replication hoạt động ra sao, cách dựng master-slave chuẩn, khi nào nó đủ làm HA, và những cái bẫy khiến nhiều đội ngũ "tưởng có dự phòng mà hóa ra không".
Replication mysql master slave: replication MySQL là gì?
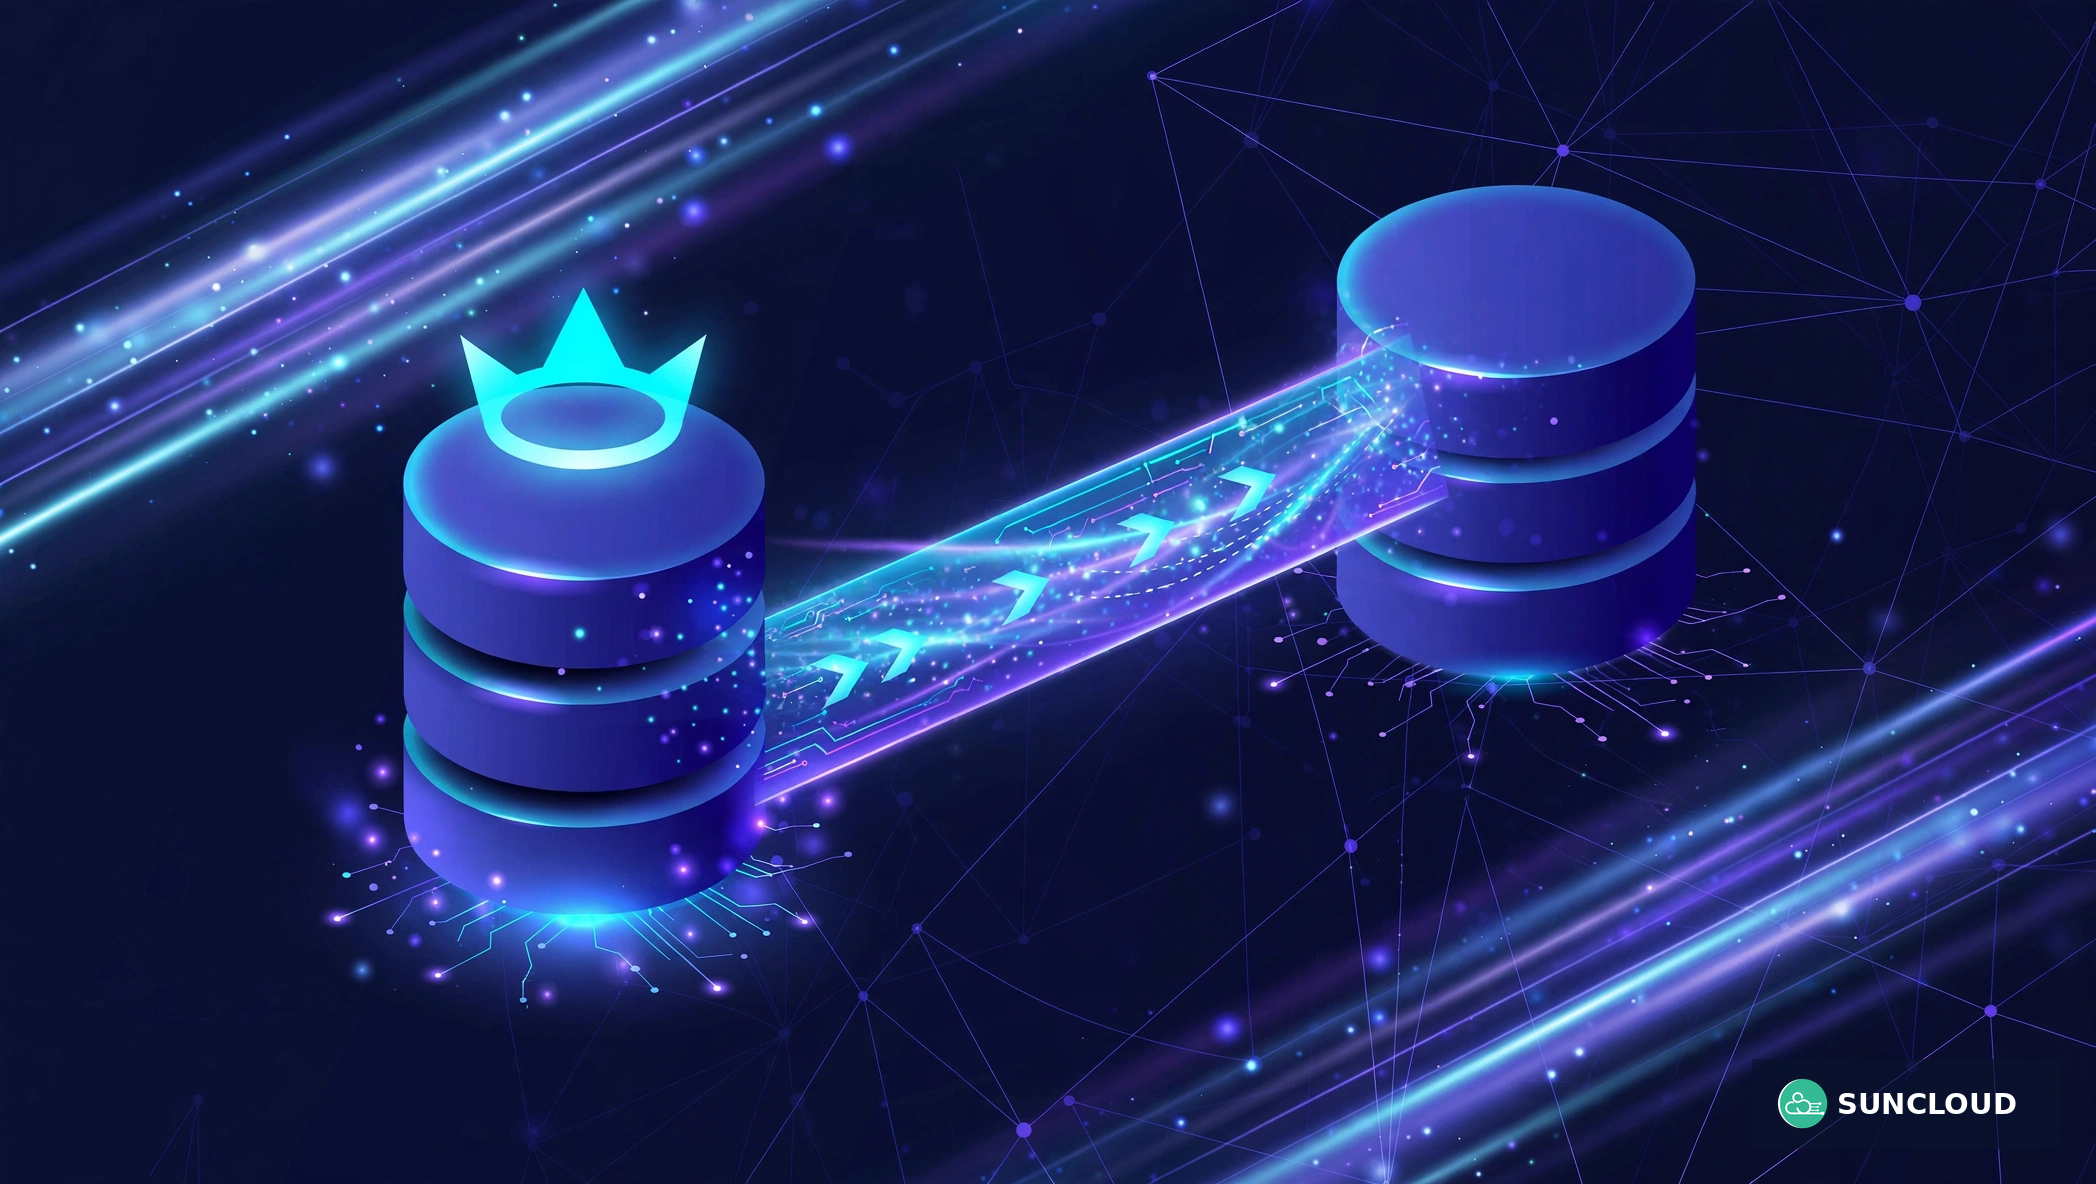
Replication là cơ chế MySQL tự động sao chép mọi thay đổi dữ liệu từ một server nguồn (master/primary) sang một hoặc nhiều server đích (slave/replica), gần như theo thời gian thực. Master ghi nhận mọi thay đổi vào binary log (binlog); slave đọc binlog đó và "diễn lại" (replay) các thay đổi lên dữ liệu của mình.
Kết quả: slave luôn có bản sao dữ liệu mới đến từng giây (độ trễ thường dưới 1 giây trong cùng datacenter). Ba lợi ích chính:
1. High Availability: master sập → chuyển slave thành master mới trong vài phút, dịch vụ tiếp tục.
2. Backup sống: slave là bản sao "nóng" — có thể backup từ slave mà không ảnh hưởng hiệu năng master.
3. Chia tải đọc: chuyển các truy vấn SELECT nặng (báo cáo, thống kê) sang slave, giảm tải cho master.
Lưu ý quan trọng: replication không thay thế backup. Nếu ai đó DROP TABLE nhầm trên master, lệnh xóa cũng được nhân bản sang slave trong 1 giây — "backup sống" không cứu được lỗi logic con người. Replication chống sự cố hạ tầng, backup chống sai lầm con người. Cần cả hai.
Replication mysql master slave: các mô hình replication phổ biến
Master-Slave cổ điển (asynchronous). Master ghi binlog, slave tự kéo về và replay — không chờ xác nhận. Ưu điểm: nhanh, master không bị chậm lại vì chờ slave. Nhược điểm: nếu master sập đúng lúc slave chưa kịp kéo log mới nhất, mất vài giây dữ liệu (RPO > 0). Phù hợp đa số SME: đơn giản, đủ tốt. Semi-synchronous replication. Master chờ ít nhất một slave xác nhận đã nhận binlog mới coi giao dịch là xong. Giảm nguy cơ mất dữ liệu xuống gần 0 mà độ trễ chỉ tăng nhẹ. Lựa chọn cân bằng cho hệ thống quan trọng (thanh toán, đơn hàng). Group Replication / InnoDB Cluster. Nhiều node cùng là master (multi-primary) hoặc một primary tự động bầu lại khi lỗi. Phức tạp hơn nhưng failover gần như tự động hoàn toàn. Phù hợp khi đội ngũ đủ năng lực vận hành. Chuỗi và cây replication. Slave có thể làm master của slave khác (chain) để mở rộng, hoặc một master nuôi nhiều slave (fan-out) cho các mục đích: 1 slave làm HA standby, 1 slave chạy báo cáo, 1 slave ở site DR xa. | Mô hình | RPO khi master sập | Độ phức tạp | Phù hợp | | --- | --- | --- | --- | | Async master-slave | Vài giây | Thấp | SME, web thông thường | | Semi-sync | ≈ 0 | Trung bình | Thanh toán, đơn hàng | | Group Replication | ≈ 0 | Cao | Đội ngũ mạnh, yêu cầu khắt khe |
Replication mysql master slave: chuẩn bị trước khi dựng replication
1. Phiên bản MySQL đồng nhất. Slave nên chạy cùng hoặc mới hơn master một bản minor. Khác major version dễ gây lỗi replay không tương thích.
2. Server ID duy nhất. Mỗi server trong cụm replication phải có server-id khác nhau trong cấu hình — trùng ID là lỗi phổ biến khiến replication không chạy mà log chẳng báo rõ.
3. Bật binary log trên master. Thêm vào my.cnf: log_bin = mysql-bin, binlog_format = ROW (khuyến nghị — ghi theo dòng, chính xác nhất cho hầu hết workload hiện đại).
4. Tài khoản replication riêng. Tạo user chỉ có quyền REPLICATION SLAVE, giới hạn IP slave. Đừng dùng root cho replication — nguyên tắc phân quyền tối thiểu.
5. Dữ liệu ban đầu đồng bộ. Slave phải xuất phát từ bản sao đúng thời điểm của master: dùng mysqldump --master-data hoặc tốt hơn là Percona XtraBackup (không khóa bảng với database lớn). Ghi lại vị trí binlog (file + position hoặc GTID) để slave biết bắt đầu replay từ đâu.
Các bước dựng master-slave cơ bản
Bước 1 — Cấu hình master (my.cnf):
server-id = 1
log_bin = mysql-bin
binlog_format = ROW
Khởi động lại MySQL, tạo user replication.
Bước 2 — Backup master và restore sang slave. Dùng XtraBackup cho database lớn (tránh khóa), hoặc mysqldump cho database nhỏ. Ghi nhận tọa độ binlog tại thời điểm backup.
Bước 3 — Cấu hình slave (my.cnf):
server-id = 2
relay_log = mysql-relay-bin
read_only = 1
read_only cực kỳ quan trọng: ngăn ứng dụng ghi nhầm vào slave gây lệch dữ liệu.
Bước 4 — Trỏ slave về master:
CHANGE MASTER TO
  MASTER_HOST='ip-master',
  MASTER_USER='repl_user',
  MASTER_PASSWORD='mat-khau-manh',
  MASTER_LOG_FILE='mysql-bin.000001',
  MASTER_LOG_POS=1234;
START SLAVE;
Bước 5 — Kiểm tra: SHOW SLAVE STATUS\G — hai dòng quan trọng nhất: Slave_IO_Running: Yes (đang kéo log được) và Slave_SQL_Running: Yes (đang replay được). Seconds_Behind_Master cho biết độ trễ (nên = 0 hoặc vài giây).
Failover: khi master sập thì làm gì?
Có slave chưa đủ — phải có quy trình chuyển đổi khi master thật sự sập:
Failover thủ công (đủ cho SME):
1. Xác nhận master chết thật (không phải sự cố mạng nhất thời) — kiểm tra từ 2 nơi độc lập.
2. Trên slave: STOP SLAVE; rồi kiểm tra đã replay hết relay log chưa (SHOW SLAVE STATUS — chờ Seconds_Behind_Master = 0).
3. Tháo read_only, nâng slave thành master: RESET MASTER; (hoặc cấu hình GTID để đơn giản hơn).
4. Chuyển ứng dụng sang IP/hostname mới — dùng hostname/DNS, đừng hard-code IP trong config app để bước này chỉ là đổi DNS.
5. Dựng lại slave mới từ master mới khi có thể.
Failover tự động: dùng Orchestrator, MHA hoặc InnoDB Cluster để tự phát hiện và chuyển đổi trong 30–60 giây. Đáng đầu tư khi downtime mỗi phút đều tốn tiền thật (thương mại điện tử, tài chính).
Quy tắc vàng: failover chưa từng diễn tập thì coi như chưa có. Mỗi quý, hãy chủ động tắt master trong giờ thấp điểm và chạy đúng quy trình — lần đầu làm sẽ phát hiện ra cả đống thứ tài liệu không ghi (DNS TTL quá dài, app cache IP cũ, firewall chưa mở port cho hướng mới...).
Giám sát replication: 3 chỉ số phải theo dõi mỗi ngày
Replication lặng lẽ chạy tốt cho đến ngày nó lặng lẽ hỏng. Ba chỉ số sau cần có mặt trong dashboard giám sát (Zabbix, Prometheus, hoặc đơn giản là script cron gửi Telegram):
1. Slave_IO_Running và Slave_SQL_Running. Cả hai phải là Yes. IO thread chết = slave không kéo được log mới (lỗi mạng, credential hết hạn); SQL thread chết = slave kéo được nhưng replay lỗi (thường do xung đột dữ liệu). Bất kỳ thread nào No quá 5 phút đều đáng báo động đỏ.
2. Seconds_Behind_Master. Độ trễ replay, lý tưởng là 0–5 giây. Trễ tăng dần là dấu hiệu slave yếu hơn master (I/O chậm, thiếu RAM) hoặc có query nặng đang kẹt. Đừng đặt ngưỡng cảnh báo quá thấp gây báo giả — ngưỡng 300 giây cho cảnh báo, 3600 giây cho sự cố nghiêm trọng là thực tế với đa số hệ thống.
3. Vị trí GTID / binlog. So sánh Executed_Gtid_Set giữa master và slave để biết slave có đang "đuổi kịp" thật không — Seconds_Behind_Master đôi khi báo 0 trong khi slave thực ra đã dừng kéo log (trường hợp hiếm nhưng đã từng xảy ra). Kiểm tra chéo 2 nguồn số liệu thì không bao giờ thừa.
Ngoài ra, hãy giám sát dung lượng disk trên slave: relay log phình to khi SQL thread kẹt có thể làm đầy ổ đĩa slave — và slave đầy đĩa thì replication chết theo kiểu "domino".
Replication làm "backup sống" như thế nào?
Ngoài HA, slave còn là công cụ backup tuyệt vời:
Backup không ảnh hưởng production. Chạy mysqldump/XtraBackup trên slave thay vì master — master đang phục vụ người dùng không bị giật vì khóa bảng hay ngốn I/O lúc backup. Với database lớn, đây là khác biệt giữa "backup êm" và "backup xong khách kêu chậm".
Point-in-time recovery nhanh. Kết hợp full backup từ slave + binlog: khi cần khôi phục về thời điểm bất kỳ (ví dụ trước khi chạy nhầm câu lệnh UPDATE), replay binlog đến đúng thời điểm đó. Nhanh hơn nhiều so với dựng lại từ backup đêm qua rồi vá thủ công.
Kiểm chứng backup tự động. Vì slave luôn replay dữ liệu mới, nó đồng thời là bằng chứng sống rằng backup chain của bạn đang hoạt động — một dạng "test restore" liên tục mà không tốn công.
Nhưng nhắc lại: replication nhân bản cả sai lầm. DROP DATABASE nhầm trên master sẽ bay sang slave trong tích tắc. Vì vậy vẫn cần backup độc lập (full + binlog) lưu nơi khác, và với dữ liệu cực kỳ quan trọng, hãy dùng delayed slave — slave trễ 1 giờ so với master, cho bạn "cửa sổ cứu hộ" 60 phút khi phát hiện xóa nhầm.
6 lỗi thường gặp và cách xử lý
1. Slave_IO_Running: No — lỗi kết nối/auth. Kiểm tra firewall port 3306 từ slave tới master, user/password, quyền REPLICATION SLAVE. Lỗi phổ biến nhất, cũng dễ fix nhất.
2. Slave_SQL_Running: No — lỗi replay. Thường do ghi trực tiếp vào slave (thiếu read_only), hoặc khác biệt schema. Xem Last_SQL_Error, sửa nguyên nhân gốc rồi SET GTID_NEXT/START SLAVE — đừng sql_slave_skip_counter bừa bãi vì sẽ gây lệch dữ liệu âm thầm.
3. Seconds_Behind_Master tăng dần. Slave replay không kịp: do truy vấn nặng trên master (đặc biệt với binlog_format STATEMENT), disk slave chậm, hoặc single-threaded replay. Giải pháp: chuyển ROW format, nâng I/O slave, bật parallel replication (slave_parallel_workers).
4. Trùng server-id. Triệu chứng: replication lúc chạy lúc không, log khó hiểu. Fix: đặt ID duy nhất cho mỗi node — kiểm tra ngay khi dựng.
5. Hết disk vì binlog. Master giữ binlog quá lâu (expire_logs_days quá lớn hoặc = 0). Đặt binlog_expire_logs_seconds = 604800 (7 ngày) và giám sát dung lượng.
6. Failover xong ứng dụng vẫn trỏ master cũ. Do hard-code IP trong config. Bài học: luôn dùng hostname/DNS/service discovery cho endpoint database.
Khi nào nên nâng cấp lên Group Replication hoặc InnoDB Cluster?
Master-slave cổ điển đủ dùng cho đa số SME, nhưng có 3 dấu hiệu cho thấy bạn đã "lớn" hơn nó:
1. Failover thủ công quá rủi ro. Nếu mỗi lần chuyển đổi đều cần người trực đêm chạy lệnh, và downtime 15–30 phút đã gây thiệt hại thật — đã đến lúc dùng MySQL InnoDB Cluster (dựa trên Group Replication): các node tự bầu leader, failover tự động trong 30–60 giây, ứng dụng kết nối qua MySQL Router nên không cần đổi config.
2. Cần ghi ở nhiều nơi. Master-slave cổ điển chỉ cho ghi ở một node. Nếu ứng dụng của bạn cần ghi ở 2 datacenter (ví dụ Hà Nội + TP.HCM), Group Replication ở chế độ multi-primary cho phép ghi ở mọi node — nhưng hãy cẩn trọng với xung đột ghi (write conflict), chỉ phù hợp khi các node ghi vào tập dữ liệu khác nhau.
3. Muốn bỏ hẳn "điểm chết" trong quy trình vận hành. InnoDB Cluster tích hợp sẵn với MySQL Shell (dba.createCluster()), quản trị bằng một công cụ duy nhất thay vì chắp vá script. Chi phí là độ phức tạp ban đầu cao hơn và yêu cầu tối thiểu 3 node (để bầu cử quorum).
Lộ trình thực tế: đừng nhảy thẳng từ "chưa có gì" lên InnoDB Cluster. Hãy đi từ master-slave cổ điển (học cách replication hoạt động) → GTID + semi-sync replication (giảm mất dữ liệu khi failover) → InnoDB Cluster khi team đã cứng. Mỗi bước đều là nền tảng cho bước sau, không bước nào phí.
Kết luận
Replication MySQL master-slave là khoản đầu tư hiệu quả bậc nhất cho độ tin cậy của database: một cơ chế cho cả hai lợi ích — HA khi master sập và backup sống để sao lưu không ảnh hưởng production. Chìa khóa thành công không nằm ở câu lệnh CHANGE MASTER TO (chỉ mất 10 phút), mà ở những việc xung quanh: read_only trên slave, quy trình failover được diễn tập, giám sát độ trễ replication, và backup độc lập đề phòng sai lầm con người.
Nếu database MySQL đang là điểm chết đơn trong hệ thống của bạn, đừng chờ đến lúc sập mới làm. SunCloud cung cấp Cloud Server và Dedicated Server hiệu năng cao cho database, hạ tầng mạng nội bộ tốc độ cao giữa các node replication, cùng đội ngũ hỗ trợ kỹ thuật 24/7. Liên hệ hotline 083 979 3434 hoặc email sales@suncloud.vn hoặc truy cập suncloud.vn để được tư vấn kiến trúc HA phù hợp.
Bài viết liên quan
- Dịch vụ lưu trữ đám mây SunCloud
- Air-gapped backup là gì? Lớp bảo vệ cuối cùng cho dữ liệu trọng yếu
- Chiến lược backup 3-2-1 cho doanh nghiệp SME: bắt đầu từ đâu?
Câu hỏi thường gặp
Replication có làm chậm master không?
Với async replication: gần như không — master chỉ thêm việc ghi binlog (vốn đã nên bật). Với semi-sync: thêm độ trễ một lần round-trip mạng tới slave (thường < 5ms trong cùng datacenter). Chỉ group replication multi-primary mới có overhead đáng kể.
Cần bao nhiêu slave là đủ?
Tối thiểu 1 slave cho HA. Mô hình phổ biến cho SME: 2 slave — 1 làm standby HA (semi-sync), 1 làm backup/báo cáo (async, có thể delayed 1 giờ). Đừng lạm dụng quá nhiều slave trực tiếp dưới một master vì tăng tải binlog.
Slave có dùng để đọc (read scaling) được không?
Được, và nên làm. Chuyển các truy vấn báo cáo, thống kê, tìm kiếm nặng sang slave để giảm tải master. Lưu ý: dữ liệu trên slave có thể trễ vài giây — không dùng cho nghiệp vụ cần đọc-ghi nhất quán tuyệt đối (ví dụ vừa nạp tiền xong tra số dư ngay).
GTID là gì, có nên dùng không?
GTID (Global Transaction Identifier) là cách định danh giao dịch toàn cụm, thay cho cặp file+position truyền thống. Nên dùng cho mọi cụm mới: failover đơn giản hơn nhiều (không cần canh tọa độ binlog thủ công), giảm hẳn lỗi con người khi chuyển đổi.
Replication qua internet (khác datacenter) có ổn không?
Ổn nếu cấu hình đúng: bật SSL cho kết nối replication, nén binlog nếu băng thông hạn chế, chấp nhận độ trễ cao hơn (dùng async). Đây là cách phổ biến để làm DR site ở tỉnh khác. Đừng dùng semi-sync qua đường truyền latency cao vì sẽ làm chậm master.